2.1.3 Marc编目
本界面为“Marc编目”专业工作台,是面向资深编目员或需要进行底层数据维护的高级操作界面。与常规的表单式编目不同,该页面直接以CNMARC(中国机读目录格式)标准字段的形式展示和编辑书目数据。页面采用
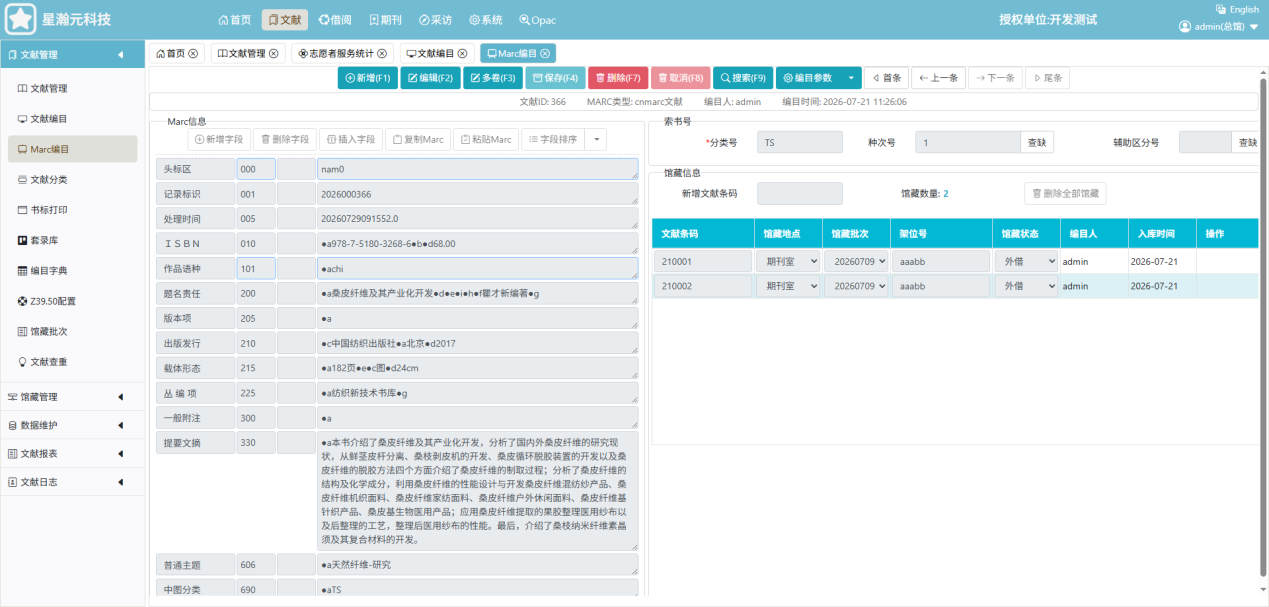
本界面为“Marc编目”专业工作台,是面向资深编目员或需要进行底层数据维护的高级操作界面。与常规的表单式编目不同,该页面直接以CNMARC(中国机读目录格式)标准字段的形式展示和编辑书目数据。页面采用经典的三段式布局:顶部为全局导航与快捷操作栏,左侧为专业编目工具栏与字段操作区,右侧为索书号与馆藏实物管理区,实现了底层元数据与物理馆藏的联动维护。
系统导航与标签:顶部展示了“首页”、“文献管理”、“志愿者服务统计”、“文献编目”及当前激活的“Marc编目”等页签,支持多任务并行切换。
快捷功能键:提供带有快捷键提示(F1-F9)的常用操作,包括“新增(F1)”、“编辑(F2)”、“多卷(F3)”、“保存(F4)”、“删除(F7)”、“取消(F8)”、“搜索(F9)”以及“编目参数”下拉菜单。此外还提供“首条”、“上一条”、“下一条”、“尾条”等浏览控件,方便编目员在书目记录间快速切换。
记录审计信息:实时显示当前记录的文献ID(366)、MARC类型(cnmarc文献)、编目人(admin)及编目时间,确保数据溯源。
该区域以原生的MARC格式字段逐行展示书目信息,是专业编目人员进行深度数据维护的核心区域:
字段工具栏:提供“新增字段”、“删除字段”、“插入字段”、“复制Marc”、“粘贴Marc”及“字段排序”等高级操作,支持对MARC结构进行灵活调整。
核心MARC字段解析:
头标区 (000):记录处理状态等系统级信息(如 nam0)。
记录标识 (001):系统唯一的记录控制号(如 2026000366)。
处理时间 (005):记录最后一次修改的时间戳。
ISBN (010):标准书号及定价信息(如 a978-7-5180-3268-6-b-d68.00)。
作品语种 (101):标识文献语言(如 achi 代表中文)。
题名责任 (200):正题名与第一责任者(如 a桑皮纤维及其产业化开发-e瞿才新编著)。
版本项 (205)、出版发行 (210)、载体形态 (215):分别记录版次、出版社/出版地/出版时间、页数/插图/尺寸等物理特征。
丛编项 (225):所属丛书信息(如 a纺织新技术书库)。
附注与摘要 (300, 330):一般附注及详细的内容提要摘要。
主题与分类 (606, 690):普通主题词(如 a天然纤维-研究)及中图分类号(如 aTS)。
注:字段内容中包含的 a、b、c、d、e等为MARC标准中的子字段标识符,用于区分同一字段下的不同信息维度。
该区域实现了MARC元数据与物理馆藏的直观绑定:
索书号生成:展示基于MARC数据生成的分类号(TS)、种次号(1)及辅助区分号,并提供“查缺”功能,便于核对排架号的连续性。
馆藏列表操作:提供“新增文献条码”输入框,用于快速录入实物图书条码;显示“馆藏数量”(当前为2)。
馆藏数据明细:表格详细列出了每一本物理图书的“文献条码”(如 210001, 210002)、“馆藏地点”(如 期刊室)、“馆藏批次”、“架位号”(如 aaabb)、“馆藏状态”(如 外借)、“编入人”及“入库时间”。支持对单行馆藏记录进行编辑或删除。
谨慎修改底层字段:MARC编目界面直接暴露了数据的底层结构,修改错误(如误删001控制号或修改了子字段标识符)可能导致OPAC检索失败或数据格式报错。建议在熟练掌握MARC21或CNMARC标准后再进行手动微调。
利用复制与粘贴功能:在处理多卷书或丛书时,可使用“复制Marc”功能完整克隆一条母记录,然后修改题名(200字段)和分册号,极大提升同套系图书的编目效率。
馆藏状态联动监控:右侧馆藏列表中的“馆藏状态”(如在馆、外借)通常与前端的借阅业务实时同步。若某条码显示为“外借”,请勿随意删除该馆藏记录,以免导致读者借阅历史数据丢失。
快捷键高效办公:熟练使用顶部提供的F1-F9快捷键(如F4快速保存,F9快速搜索),可以显著提升专业编目员的大规模数据处理速度。
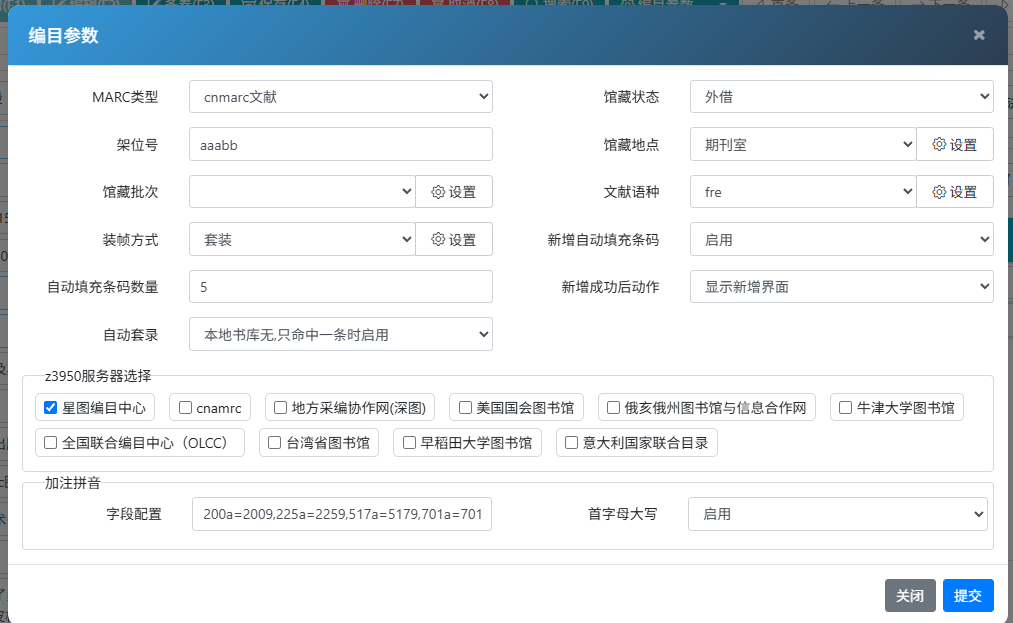
本界面为“编目参数”设置弹窗,是图书馆管理员用于自定义编目规则、规范数据录入标准以及配置外部数据源的核心控制面板。该弹窗叠加在文献编目主界面之上,采用清晰的表单布局,涵盖了MARC格式、馆藏默认值、自动化处理规则、Z39.50外部服务器选择以及拼音自动加注设置。通过合理配置这些参数,可以大幅提升新书编目的效率与数据的一致性。
表单上半部分主要用于设定编目的基础格式与新增馆藏时的默认属性:
MARC类型:下拉选择编目数据所遵循的标准格式,当前默认为“cnmarc文献”(中国机读目录格式)。
架位号:设置默认的排架位置标识符(如示例中的“aaabb”),便于后续库内盘点与定位。
馆藏状态:设定新增文献入库时的默认状态,如“外借”、“在馆”或“阅览”等。
馆藏地点:指定文献默认存放的物理位置或分馆(如示例中的“期刊室”),右侧带有“设置”按钮可自定义地点选项。
馆藏批次:下拉选择默认的采购或入藏批次,方便后续按批次进行统计与管理。
文献语种:设定默认录入的文献语言代码(如示例中的“fre”代表法语),右侧同样提供“设置”入口维护语种词典。
装帧方式:设定图书的默认装帧类型(如“套装”、“精装”、“平装”等),支持通过“设置”按钮扩展选项。
为了减少重复手动操作,系统提供了一系列智能辅助选项:
新增自动填充条码:控制是否在新增馆藏时自动生成连续的文献条码号,选项包括“启用”或“禁用”。
自动填充条码数量:当启用自动填充时,设定一次性连续生成的条码数量(如示例中的“5”个)。
新增成功后动作:定义在完成一次编目或馆藏新增后系统的默认跳转行为,如“显示新增界面”以继续下一条录入,或返回列表页。
自动套录:设定智能套录的触发条件,如示例中的“本地书库无,只命中一条时启用”。即当扫描或输入ISBN时,若本地无此书目且外部/套录库仅命中一条记录,系统将自动拉取该数据,实现“即扫即编”。
表单中下部为Z39.50协议(国际标准信息检索协议)的服务器配置区,用于连接外部权威图书馆或编目中心获取标准书目数据:
多源服务器勾选:提供了丰富的国内外权威数据源供选择,包括“星图编目中心”(当前已勾选)、“cnamrc”、“地方采编协作网(深图)”、“美国国会图书馆”、“全国联合编目中心(OLCC)”、“台湾省图书馆”、“早稻田大学图书馆”等。
使用场景:在进行“新增、套录”操作时,系统会根据此处勾选的服务器,并行或依次向这些外部库发送检索请求,获取最准确、最完整的MARC数据。
表单底部新增了针对中文编目的智能辅助功能:
字段配置:允许管理员自定义需要自动加注拼音的MARC字段及子字段。示例中的配置“200a=2009, 225a=2259, 517a=5179, 701a=701”分别代表正题名(200a)、丛编项(225a)、其他题名(517a)和责任者(701a)等。系统会根据此规则在保存时自动生成对应的拼音。
首字母大写:控制生成的拼音格式,当前设置为“启用”,即拼音的首字母会自动大写(如“Sangpi Xianwei”),便于OPAC检索界面的美观展示与排序。
统一默认规则:建议在系统初始化或月初集中采编前,统一配置好“馆藏地点”、“馆藏状态”和“装帧方式”等默认值。这样在批量录入新书时,系统会自动带出这些参数,减少逐项选择的工作量。
条码生成策略:若图书馆采用系统自动生成条码的策略,“自动填充条码数量”需与实际采购的复本数或批次量相匹配,避免造成条码号段的浪费或断裂。
外部数据源优化:勾选过多的Z39.50服务器可能会增加检索耗时。建议日常编目只保留响应速度快、数据质量高的核心服务器(如星图编目中心或国图),在遇到冷门书籍时再临时勾选特定地区或国外的专项图书馆。
拼音加注配置:对于以中文藏书为主的图书馆,务必确保“加注拼音”功能已启用并配置了正确的字段映射。这不仅能提升OPAC端按拼音首字母检索的体验,还能在打印书标、排架时提供规范的拼音指引。
参数生效范围:此类全局或用户级的编目参数,通常在点击右下角的“提交”按钮保存后生效。若需放弃更改,可点击“关闭”或右上角的“X”退出弹窗。
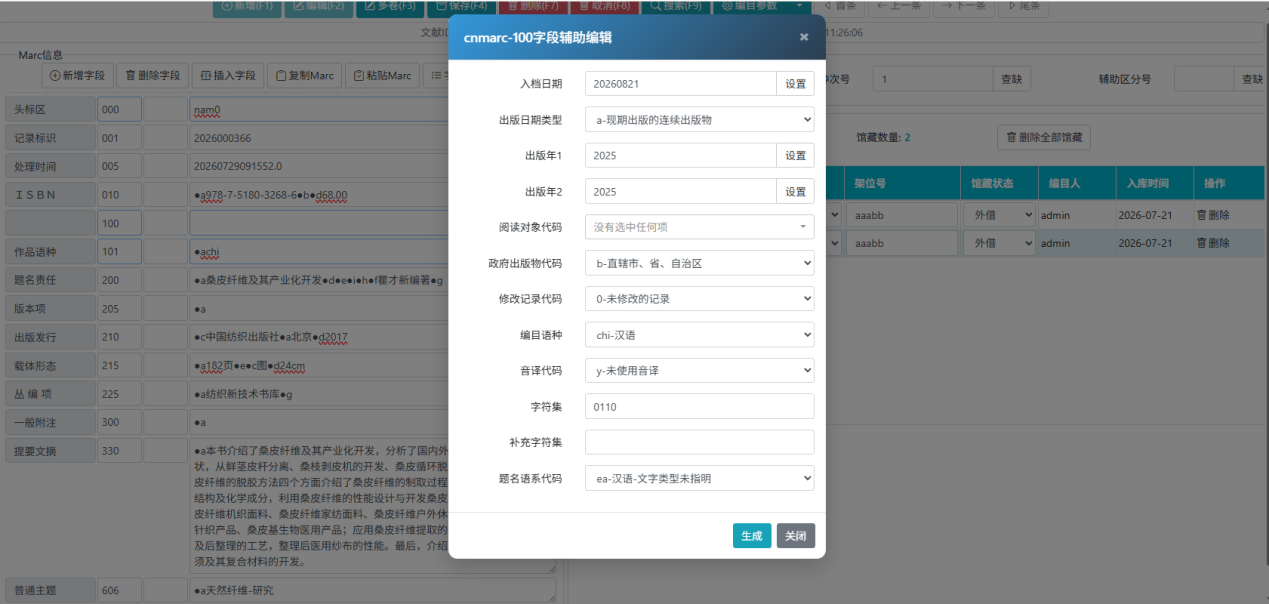
本界面为“cnmarc-100字段辅助编辑”弹窗。在Marc编目主界面中,专业编目员通常通过双击“头标区(000字段)”或专用的辅助编辑入口唤起此对话框。该工具将MARC格式中晦涩难懂、由固定长度和代码组成的头标区数据,转化为直观的下拉选项和输入框,极大地降低了专业编目的门槛,确保底层元数据的规范性与准确性。
弹窗内的表单严格对应CNMARC标准中100字段(或000头标区)的固定字符位定义,涵盖了文献出版、编目及字符集等核心属性:
入档日期:记录该文献数据录入系统的日期(如 20260821),通常系统会自动带出当前日期,支持手动“设置”修改。
出版日期类型:定义文献的出版性质。示例中选中的是“a-现期出版的连续出版物”(对应代码 a),其他常见选项还包括单册、古籍、即将出版等。
出版年1 & 出版年2:分别记录文献的起始出版年份和结束年份(如连续出版物的最新出版年)。示例中均为 2025,右侧配有“设置”按钮以便快速调整。
阅读对象代码:标识文献的适用人群或阅读级别(如成人、儿童、普通青少年等),当前显示为“没有选中任何项”。
政府出版物代码:标识文献是否为政府出版物及所属行政级别。示例中选中的是“b-直辖市、省、自治区”(对应代码 b)。
修改记录代码:标识该MARC记录自创建以来的修改状态。示例中选中的是“0-未修改的记录”(对应代码 0)。
编目语种:标识编目数据本身使用的语言。示例中选中的是“chi-汉语”(对应代码 chi)。
音译代码:标识题名或责任者是否使用了音译规则。示例中选中的是“y-未使用音译”(对应代码 y)。
字符集 & 补充字符集:定义记录中使用的字符编码标准。示例中字符集为“0110”(通常指ISO 10646 Unicode或GB2312等中文字符集),补充字符集当前为空。
题名语系代码:标识正题名的语言和文字类型。示例中选中的是“ea-汉语-文字类型未指明”(对应代码 ea)。
生成:编目员在完成各项下拉选择和输入框填写后,点击“生成”按钮,系统会自动将这些人类可读的选项转换为标准的、符合字符长度要求的MARC头标区代码字符串,并回填到左侧Marc编目界面的“头标区(000)”字段中。
关闭:点击“关闭”按钮则放弃当前修改,直接退出弹窗,头标区数据保持原有状态不变。
降低专业门槛:MARC头标区(000字段)通常由16位或更长的一串字母和数字混合代码组成(例如 nam0...),人工记忆和输入极易出错。此辅助编辑器通过语义化的下拉菜单,让编目员即使不熟悉底层代码也能准确录入。
确保数据规范性:通过下拉框限制输入范围,避免了非法字符的录入,保证了导出MARCXML或与其他图书馆系统进行数据交换时的兼容性。
连续出版物编目注意:在处理期刊、杂志等连续出版物时,“出版日期类型”和“出版年1/2”的设定尤为关键,这直接关系到系统在计算期刊的卷期、预测下一个到期记录时的准确性,务必根据实际出版情况认真选择。
编目语种与题名语系:对于引进版外文原版书,需特别注意将“编目语种”和“题名语系代码”调整为对应的外语代码(如 eng),以确保OPAC检索时的多语言展示效果。