2.3.1 导入馆藏数据
星瀚元图书馆集群管理系统 — 导入馆藏数据功能说明一、 页面概览本界面位于“数据维护”模块下的“导入馆藏数据”页面,是图书馆实现书目数据批量自动化录入的核心工具。在日常采编工作中,面对大批量的新书入藏
星瀚元图书馆集群管理系统 — 导入馆藏数据功能说明
一、 页面概览
本界面位于“数据维护”模块下的“导入馆藏数据”页面,是图书馆实现书目数据批量自动化录入的核心工具。在日常采编工作中,面对大批量的新书入藏,逐条手动录入书目信息效率极低。该页面支持通过上传标准的MARC格式文件(如ISO2709格式),将外部数据源或书商提供的书目数据快速解析并导入系统,随后生成馆藏记录,极大提升了编目与入藏的效率。
二、 文件上传与参数配置区
页面顶部提供了MARC文件的上传与解析环境配置入口:
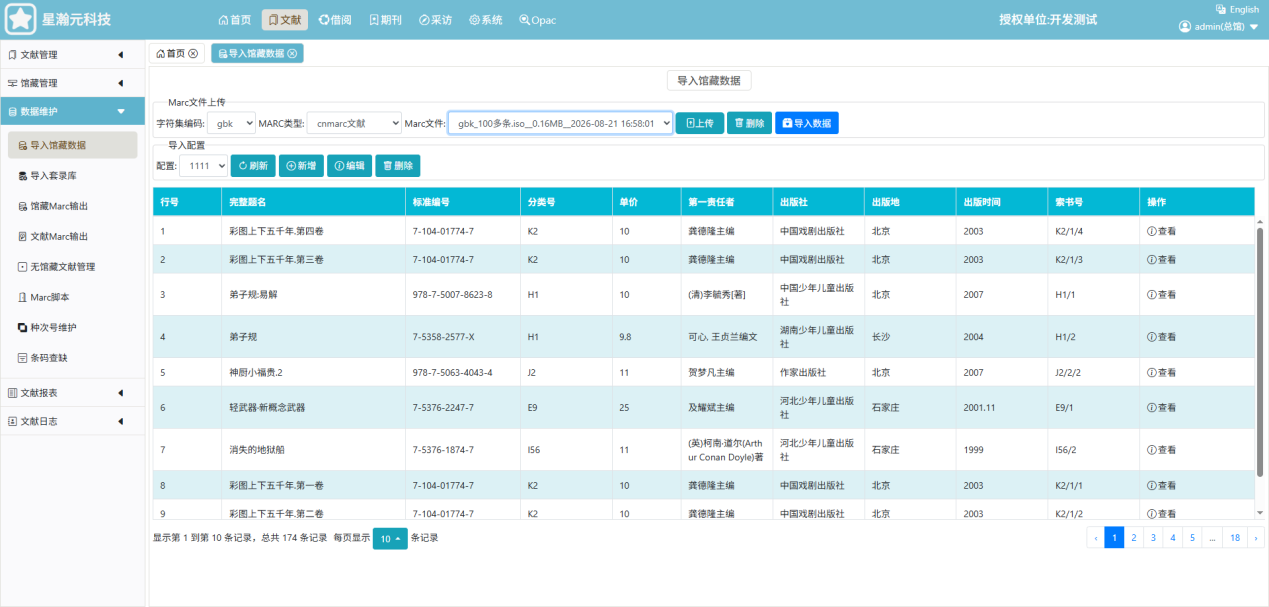
字符集编码:下拉选择框(当前选中“gbk”),用于匹配MARC源文件的字符编码,防止中文书目数据(如书名、责任者)在导入时出现乱码。
MARC类型:下拉选择框(当前选中“cnmarc文献”),指定源数据的标准格式(如CNMARC、USMARC等),确保系统能正确解析字段。
Marc文件:显示已选择的待上传文件(如“gbk_100多条.iso_0.16MB_2026-08-21 16:58:01”)。
操作按钮:
上传:将本地MARC文件传输至系统服务器。
删除:清除当前已选择的文件,以便重新选择。
导入数据:核心执行按钮。在文件上传并完成格式校验后,点击此按钮将文件内的书目数据批量写入系统数据库。
三、 导入配置与数据预览区
文件上传后,系统会对MARC数据进行解析,并提供配置管理与预览功能:
导入配置:下拉框(当前选中“配置: 1111”)及“刷新”、“新增”、“编辑”、“删除”按钮。系统通常支持预设多种导入模板(如不同书商的MARC字段映射规则),馆员可根据数据源选择对应的解析配置,确保分类号、责任者等字段能正确落入系统的对应字段中。
数据预览列表:实时展示解析出来的书目元数据清单(当前显示第1到第10条,总共174条记录),包含以下核心字段:
基础书目信息:“行号”、“完整题名”(如《彩图上下五千年.第四卷》、《弟子规:易解》)、“标准编号”(ISBN,如7-104-01774-7)、“分类号”(如K2, H1)、“索书号”(如K2/1/4)。
出版与资产信息:“单价”(用于资产登记)、“第一责任者”、“出版社”、“出版地”、“出版时间”。
操作:“查看”按钮可逐条核对解析出的详细MARC字段,确认无误后再正式入库。
四、 左侧功能导航与业务闭环
当前页面处于数据维护与采编业务的源头环节,与左侧菜单功能紧密衔接:
导入馆藏数据(当前页):批量解析外部MARC文件,生成书目及馆藏预检数据。
导入套录库:通常用于将外部数据先导入到一个临时的套录库中,经过人工校对、查重后再正式生成馆藏,降低错入风险。
文献入藏/馆际文献入藏:MARC数据成功导入系统后,需为其分配具体的馆藏地点、条码号,完成实物图书的正式入藏登记。
馆藏Marc输出/文献Marc输出:将系统内的馆藏数据反向导出为MARC文件,用于数据备份或向上级机构上报。
五、 业务场景与操作建议
导入前的“套录库”预检机制:面对书商提供的大批量MARC文件(如本例中的174条),建议不要直接点击“导入数据”。可先结合左侧的“导入套录库”功能进行预导入,人工抽查几条(如《轻武器-新概念武器》或《消失的地狱船》)的解析结果,确认“配置: 1111”的字段映射无误、无乱码后,再将干净、准确的数据正式导入馆藏库。
严格核对“字符集编码”与“MARC类型”:这是导致导入失败或乱码的重灾区。如果书商提供的是USMARC格式但误选了CNMARC,或者文件是UTF-8编码但误选了GBK,都会导致数据错乱。遇到解析异常时,第一时间检查这两个下拉框的配置。
利用“导入配置”适配多书商规则:不同的书商(如新华书店、第三方数据商)提供的MARC文件字段顺序可能不同。建议针对常用书商在“导入配置”中提前建立专属模板(如“配置: 1111”可命名为“某某书商CNMARC模板”),下次导入同类型文件时直接调用,避免重复设置。
导入后的资产核销与入藏衔接:MARC数据导入成功后,系统生成了书目记录,但此时图书尚未成为可借阅的实体馆藏。下一步必须进入“文献入藏”模块,为这174条记录批量生成馆藏条码、分配“馆藏地点”(如中文书库)和“索书号”,并登记“单价”完成财务资产入账,最终形成账实相符的图书馆藏。
星瀚元图书馆集群管理系统 — 导入数据配置弹窗功能说明
一、 弹窗概览
本弹窗为“导入馆藏数据”功能的核心配置环节,通常在点击“新增”或“编辑”导入配置时触发。其主要作用是将外部MARC文件中的原始字段(如905f、901a等)与系统内部的馆藏属性(如索书号、文献条码、馆藏地点等)进行精准映射。通过预设不同的配置模板,馆员可以高效适配多家书商或不同数据供应商的MARC数据格式,实现批量书目与馆藏数据的自动化、标准化入库。
二、 基础配置项
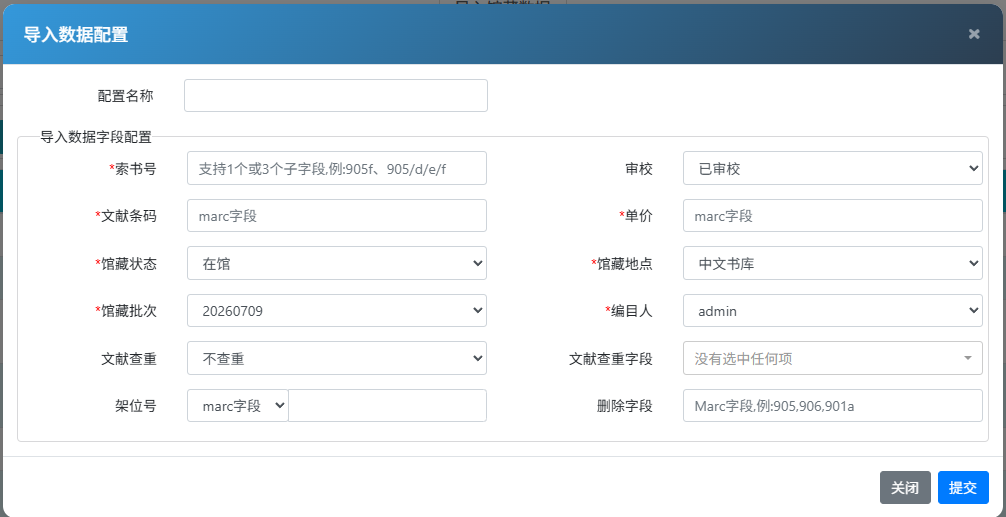
配置名称:必填项,用于自定义并保存当前的映射规则。建议采用“书商名称+数据格式+日期”的命名规范(如“新华书店_CNMARC_2026”),便于后续在导入主页面快速调用和复用。
三、 导入数据字段配置详解
该区域是MARC字段与系统馆藏字段的映射核心,分为必填项(带红色星号 *)和选填项:
1. 书目与馆藏核心映射
索书号:输入框,支持指定1个或3个子字段(如示例中的 905f、905/d/e/f)。系统会按照设定的MARC子字段(通常来自905字段)自动解析并生成图书排架所需的索书号。
文献条码:输入框,通常填写 marc字段(如901a或905d)。系统会提取MARC中对应的条码字段,直接作为该册图书的唯一物理身份标识。
单价:输入框,填写对应的MARC字段(如010d或905c)。用于自动抓取图书的定价,直接同步至系统的资产财务模块。
馆藏状态:下拉选择框(当前默认“在馆”)。定义数据导入后图书的初始流通状态,通常为“在馆”或“可供借阅”。
馆藏地点:下拉选择框(当前默认“中文书库”)。指定批量导入图书的默认存放位置,需与图书馆实际的书库、阅览室架构保持一致。
编目人:下拉选择框(当前默认“admin”)。指定这批导入数据的责任馆员,用于后续的编目工作量统计与数据追溯。
馆藏批次:下拉选择框(当前默认“20260709”)。将本次导入的图书归集到特定的入藏批次中,便于后期按批次进行资产盘点或报表统计。
2. 查重与质量控制
审校:下拉选择框(当前默认“已审校”)。设定导入数据的质量级别,若为“已审校”则直接生效,若为“未审校”则可能需要人工二次复核。
文献查重:下拉选择框(当前默认“不查重”)。控制导入时的查重策略。若选择查重,系统会自动比对库中已有书目,防止重复建书。
文献查重字段:下拉选择框(当前默认“没有选中任何项”)。配合查重功能,指定用于比对的唯一标识(如ISBN、正题名+责任者等),提高查重的精准度。
3. 扩展与清洗配置
架位号:下拉/输入框(当前默认 marc字段)。可指定MARC中的特定字段(如905e)来自动提取图书的具体架位信息,实现精准排架。
删除字段:输入框(示例:Marc字段,例:905,906,901a)。用于数据清洗。在导入过程中,系统会自动剔除这些指定的MARC字段,防止冗余或敏感数据进入系统,保持馆藏数据库的干净整洁。
四、 操作建议与业务场景
建立多书商专属配置模板:不同书商提供的MARC文件字段定义可能差异很大(例如A书商用901a存条码,B书商用905d存条码)。建议在首次对接新书商数据时,仔细核对MARC原始文件,在此弹窗中精确配置好映射关系并保存为专属“配置名称”。后续收货时直接调用该模板,实现“一键导入”。
善用“删除字段”优化馆藏库:外部书商数据往往包含大量图书馆不需要的编目冗余字段。建议在配置时,将诸如905$p(复本数)、906(个人名称主题)等非核心馆藏字段填入“删除字段”中。这样导入后,系统的MARC存储会更精简,提升检索效率。
严格把控“文献查重”防冗余:在进行大规模新书入藏时,务必根据业务需求调整“文献查重”策略。如果是首批建库,可选择“不查重”;如果是日常补采,强烈建议开启查重并指定“标准编号(ISBN)”为查重字段,避免同一本书因多次导入而产生多个重复的书目主记录。
规范“馆藏批次”与“编目人”的默认值:为了方便后期的资产审计与绩效统计,建议在配置模板时就固定好“馆藏批次”(如按年月自动生成的批次号)和“编目人”。这样即使是大批量数据交由外包人员操作导入,也能确保数据归属清晰、资产批次明确