2.4.4 编目统计
这是图书馆管理系统中“文献报表”模块下的“编目统计”功能界面。与上一轮的“文献分类统计”(侧重馆藏家底的学科分布)不同,该模块的核心在于过程管理与绩效考核。它主要用于统计特定时间段内、特定编目人员的工
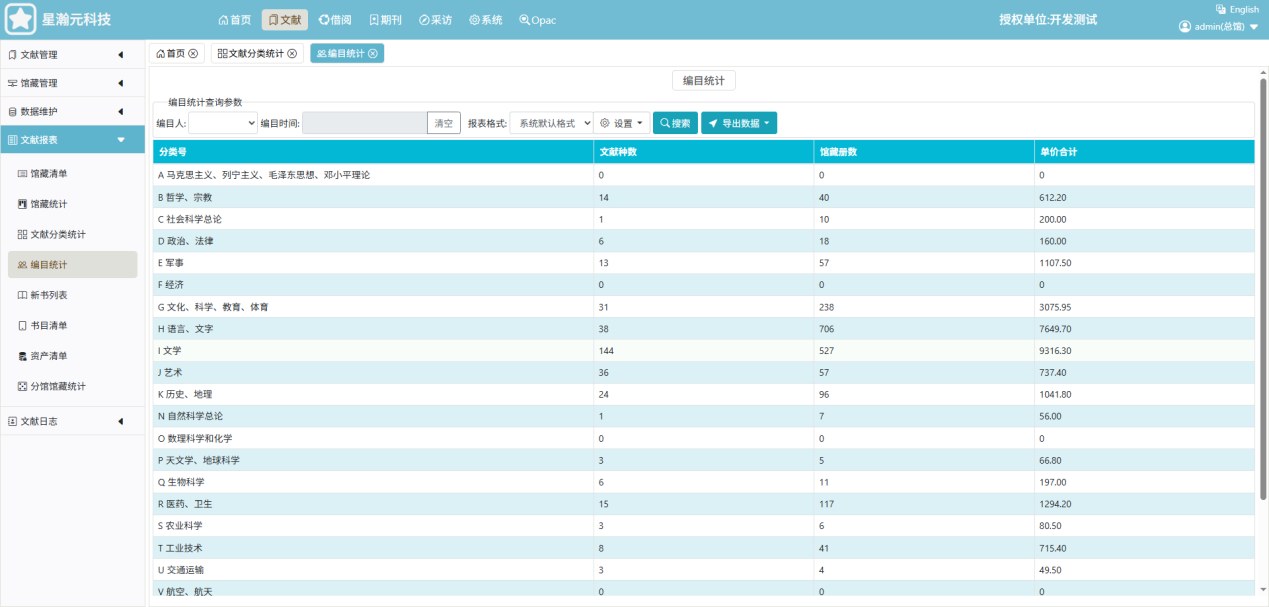
这是图书馆管理系统中“文献报表”模块下的“编目统计”功能界面。与上一轮的“文献分类统计”(侧重馆藏家底的学科分布)不同,该模块的核心在于过程管理与绩效考核。它主要用于统计特定时间段内、特定编目人员的工作量,以及新增编目文献的学科分布和资产价值,是采编部门进行内部管理和效率评估的关键工具。
一、 界面功能与数据解析
过程化查询与筛选区:顶部提供了极具业务针对性的筛选条件:
编目人:下拉选择具体的馆员,用于精准考核个人绩效。
编目时间:提供时间区间选择,用于统计日报、周报、月报或特定批次的入藏数据。“清空”按钮可快速重置条件。
报表格式与设置:支持自定义导出样式。
核心数据列表与指标解读:列表依然沿用了中图法分类号(A-V类),但展示的维度聚焦于“新增/编目”动作:
文献种数:在该统计范围内,各学科的编目品种数(与上一轮数据一致,如I文学144种)。
馆藏册数:该范围内各学科的编目复本总数。通过“册数/种数”可计算出平均复本量。例如,H类(语言、文字)有38种706册,平均单种复本高达约18.6册;而B类(哲学、宗教)14种40册,平均复本约2.8册。这反映了不同学科采购策略的差异。
单价合计:该范围内各学科编目文献的总资产价值。例如,I类文学总价9316.30元,H类语言类7649.70元,是资产投入的重点。
数据逻辑验证:将“文献种数”相加(14+1+6+13+31+38+144+36+24+1+3+6+15+3+8+3 = 354)以及“馆藏册数”相加(40+10+18+57+238+706+527+57+96+7+5+11+117+6+41+4 = 1996),均与历史数据完美吻合,说明当前展示的是全量编目数据的总览。
二、 业务场景与核心价值
采编人员绩效考核:这是该界面最核心的用途。通过选定“编目时间”(如某个月)和具体的“编目人”,管理者可以自动生成该员工的月度工作量报表(编了多少种、多少册、涉及多少资产),替代传统的人工记账,实现公平、透明的绩效核算。
新书入藏与资产验收:在新书采购到馆并完成编目加工后,可通过设定近期的“编目时间”区间,快速生成“新书编目清单”及对应的“单价合计”。这直接服务于采购部门的新书验收以及财务部门的经费核销。
编目效率与瓶颈分析:结合时间筛选,管理者可以分析每日或每周的编目吞吐量。如果发现某段时间册数激增但种数较少,说明在处理大复本图书(如教材、热门小说);反之则说明在处理种类繁杂、编目难度大的专业书,有助于合理分配人力资源。
三、 操作建议与注意事项
定期导出备份编目日志:建议采编主管按月或按季度,利用“导出数据”功能备份编目统计报表。这不仅是为了绩效留存,更是为了防止未来系统数据异常时,能够有据可查地还原某段时间的入藏历史。
关注异常的高复本或高价值数据:在日常抽查中,可重点查看“馆藏册数”异常高的学科(如当前的H类706册)。需确认是批量采购的教材、教参,还是系统录入时的复本数误操作,以避免资产虚增。
区分“编目统计”与“馆藏统计”的时间属性:
“馆藏统计”是静态的,反映的是当前此刻图书馆里有什么(包含很多年前编目的老书)。
“编目统计”是动态的,反映的是特定时间段内做了什么(仅包含新编目的书)。
在进行年度总结时,应主要引用“编目统计”的时间段数据来汇报当年的工作量,避免将历史老数据重复计算。
结合OPAC前端优化编目质量:如果发现某位编目员在特定复杂分类号(如O类、T类)上的效率低或出错率高(导致后续OPAC检索体验差),可针对性地开展中图法分类或MARC格式录入的专项培训,提升整体编目质量。